Le problème
Une infrastructure multisite manquait de visibilité sur certains composants. Des alertes tardives et une observabilité insuffisante compliquaient l’identification de la cause des incidents.
Étude de cas 03 · Observabilité & supervision
Visibilité opérationnelle et remontée plus exploitable des incidents. Un aperçu du contexte, des choix techniques et des éléments permettant d’apprécier le résultat.
01 / Le besoin
Une infrastructure multisite manquait de visibilité sur certains composants. Des alertes tardives et une observabilité insuffisante compliquaient l’identification de la cause des incidents.
Rendre les signaux techniques exploitables rapidement pour détecter les saturations, qualifier les alertes et faciliter les diagnostics.
Travail technique autour de la supervision, des indicateurs et des alertes avec Zabbix, Grafana et une composante de centralisation ou consultation des journaux.
02 / Architecture
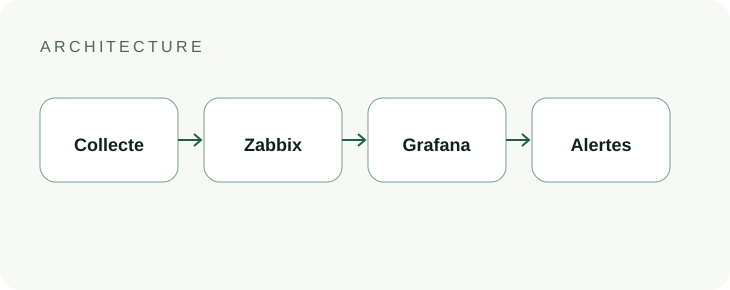
Les composants et leurs rôles dans l’architecture.
03 / Intervention
Les points essentiels de la mise en œuvre et les arbitrages de fiabilité à examiner.
Choisir les éléments dont l’indisponibilité ou la saturation crée un incident métier : connectivité, processeur, mémoire, stockage et services.
Organiser la remontée des métriques et événements, avec des conventions homogènes pour les hôtes et les environnements.
Relier les indicateurs de capacité, disponibilité et comportement applicatif à un diagnostic exploitable.
Distinguer incidents réels et bruit d’alerte, avec une priorité, un contexte et une procédure d’escalade adaptés.
04 / Résultats
05 / Traçabilité
Points de contrôle : configuration, état des services et suivi des opérations.
Statut des hôtes, métriques de service et période d’observation.
Seuils, conditions de déclenchement, canaux et exemple d’événement traité.
Échantillon d’incidents datés avant et après les changements, avec méthode de calcul explicite.
Disponibilité des services · latence réseau
CPU / mémoire / espace disque
Événements et criticité des alertes
Journaux applicatifs et système
Heure de détection → heure de résolution
06 / Pour aller plus loin
Prestation associée
Découvrez le périmètre et les livrables possibles pour cette catégorie de projets.
Consulter l’offre associée ↗Un besoin similaire ?
Je travaille avec votre équipe pour cadrer le chantier, réaliser les changements et transmettre les procédures à vos développeurs.
Autres expériences